Comme la plupart des gens, je cherche sur Google ou sur Bing. Je tape quelques mots, et la réponse arrive en une fraction de seconde. Cette rapidité vient d’un travail fait longtemps avant ma requête : des robots ont parcouru le Web, retenu le texte des pages et rangé ce texte dans un catalogue géant.
Ce catalogue s’appelle un index, et il coûte très cher à construire. C’est aussi la raison pour laquelle la recherche sur le Web se joue entre quelques entreprises, presque toutes américaines. Celui qui veut lancer un moteur aujourd’hui doit soit refaire cette collecte, soit louer l’accès à celle d’un autre.
Deux noms européens répondent à ce constat, et ils désignent deux choses différentes. Open Web Search est un projet financé par l’Union européenne, qui a construit cette machinerie en commun. Open Web Index est le catalogue que cette machinerie fabrique et publie, ouvert à qui veut s’en servir.
Cet article explique ce que fait le projet, ce que contient son index, comment celui-ci est fabriqué, comment on y accède et ce que sa licence autorise. Les exemples portent sur des données françaises.
Distinguer l’index et le moteur de recherche
L’index d’un moteur porte un nom précis, celui d’index inversé. Il stocke le texte des pages à l’envers de ce que l’on imagine : au lieu de partir d’une page pour retrouver ses mots, il part d’un mot pour retrouver ses pages.
À l’entrée « logiciel », il donne la liste des pages où ce mot apparaît. Chercher « logiciel libre » revient alors à croiser deux de ces listes, puis à trier ce qui reste. Cette structure explique la vitesse de réponse, et elle explique aussi le coût, car il faut avoir lu tout le Web pour la remplir.
Un moteur ajoute une seconde couche par-dessus. Elle classe les réponses, écarte les pages jugées inutiles, applique des règles éditoriales et dessine l’interface. La première couche coûte cher et se ressemble beaucoup d’un moteur à l’autre. La seconde fait la différence entre deux services.
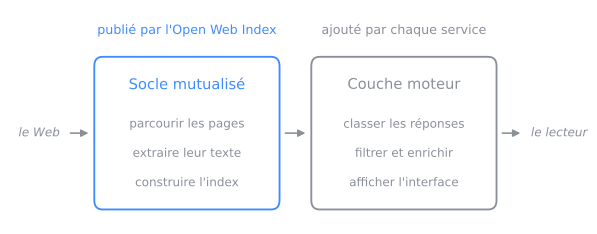
L’Open Web Index publie le socle. La couche moteur reste le travail de chaque service.
Ce partage explique l’idée du projet. Une seule collecte peut alimenter beaucoup de moteurs, à condition que son résultat soit publié dans un format que d’autres savent lire.
Situer le projet Open Web Search
Construire ce socle demande des machines, du temps et de l’argent. En Europe, cette dépense a pris la forme d’un projet de recherche public.
Le projet OpenWebSearch.eu est financé par le programme Horizon Europe. Ce programme est le principal instrument de financement de la recherche et de l’innovation dans l’Union européenne, doté de 93,5 milliards d’euros pour la période 2021 à 2027. Il attribue cet argent par appels à projets, à des consortiums qui réunissent des laboratoires de plusieurs pays.
Le projet a démarré le 1er septembre 2022 et s’est achevé le 28 février 2026, pour un budget de 8 502 621,75 euros entièrement couvert par l’Union européenne. Il réunit quatorze centres de recherche et de calcul répartis dans sept pays, dont le CERN, l’Académie bavaroise des sciences, l’université Radboud et l’Open Search Foundation, une association allemande à but non lucratif. La coordination revient à l’université de Passau.
L’objectif annoncé est explicite dans l’intitulé officiel du projet : soutenir la souveraineté numérique de l’Europe. Le site du projet présente l’accès à l’information comme aujourd’hui contrôlé par un petit nombre d’acteurs non européens, et propose une fondation technique commune plutôt qu’un moteur de plus.
La fin du financement laisse ouverte la question de la suite. Le projet décrit une phase de pérennisation, avec l’idée d’un index maintenu comme infrastructure publique et le choix d’une forme juridique adaptée, par exemple une entité européenne à but non lucratif. L’infrastructure continue de publier des lots quotidiens en août 2026.
Regarder ce que contient l’Open Web Index
Le portail de l’Open Web Index publie l’état de l’infrastructure et les chiffres de la collecte. Cette page se consulte sans compte et se met à jour tous les jours.
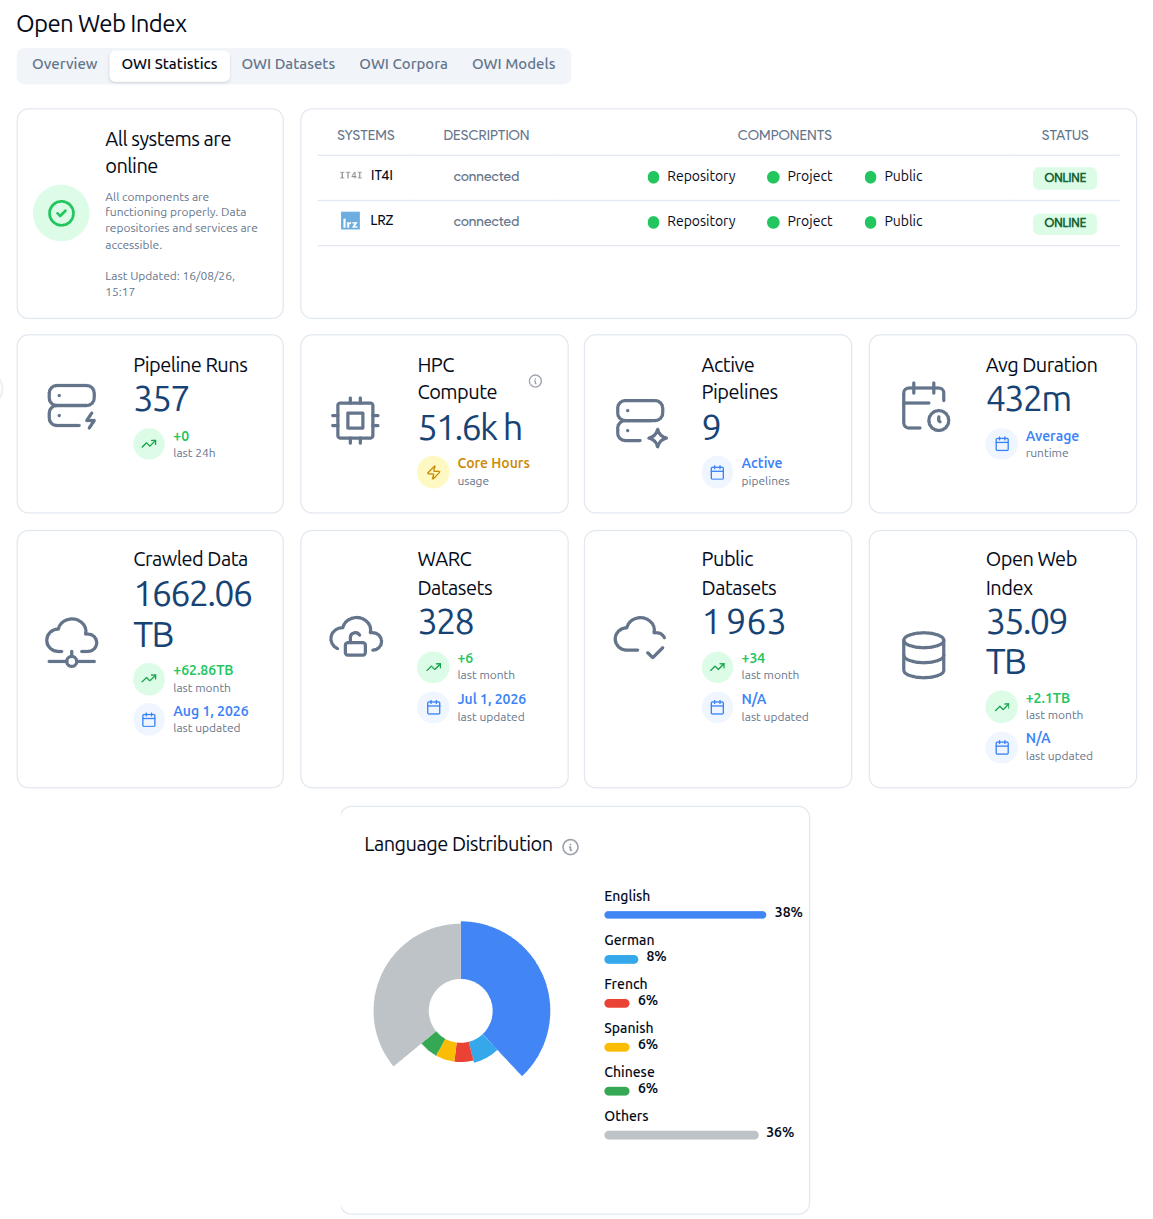
Le portail de l’Open Web Index le 16 août 2026.
Deux volumes se distinguent. Les 1 662,06 téraoctets de données collectées correspondent aux pages archivées telles qu’elles ont été reçues. Les 35,09 téraoctets de l’Open Web Index correspondent au résultat traité, beaucoup plus compact, qui rassemble le texte des pages, leurs métadonnées et les index. Le site du projet annonce par ailleurs 9,14 milliards d’adresses et 185 langues.
La répartition par langue mérite un regard attentif. L’anglais représente 38 % des pages, l’allemand 8 %, le français, l’espagnol et le chinois 6 % chacun. Un corpus français existe donc réellement, tout en restant minoritaire dans un ensemble dominé par l’anglais.
Deux centres de calcul alimentent l’ensemble, IT4I en Tchéquie et LRZ en Allemagne. Le tableau de bord affiche leur état, le nombre de chaînes de traitement actives et les heures de calcul consommées, soit 51 600 heures cœur au moment de la capture.
Suivre la fabrication de l’index
La fabrication commence par un crawler, un programme qui suit les liens de page
en page et enregistre ce qu’il reçoit. Celui du projet s’appelle OWLer. Il
respecte le fichier robots.txt par lequel un site déclare ce qu’il accepte de
voir collecter, et il écrit ses réponses au format WARC, l’archive standard des
collectes web.
Ces archives passent ensuite dans une chaîne de traitement. La bibliothèque Resiliparse, exécutée sur Apache Spark, sépare le contenu principal d’une page de ses menus, de ses bandeaux et de ses publicités. Une dernière étape construit l’index inversé au format CIFF, pour Common Index File Format, et range les métadonnées dans des fichiers Parquet, un format tabulaire compressé conçu pour l’analyse.
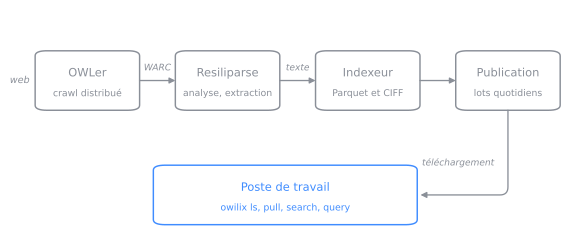
La chaîne s’arrête à la publication des lots. Ce qui vient ensuite appartient à chaque application.
Ce choix de formats compte plus qu’il n’y paraît. CIFF a été conçu pour que des moteurs différents lisent le même index. La page d’état du projet cite Apache Lucene, Elasticsearch, OpenSearch et PyTerrier comme cibles d’importation, ce qui évite d’imposer un moteur unique à ceux qui reprennent les données.
Ouvrir le catalogue des lots
L’index se publie par lots. Un lot est une tranche de temps, le plus souvent une seule journée, pour un centre de calcul donné. Le portail les présente sous forme de fiches, avec leur taille, leur nombre de fichiers et leur collection.
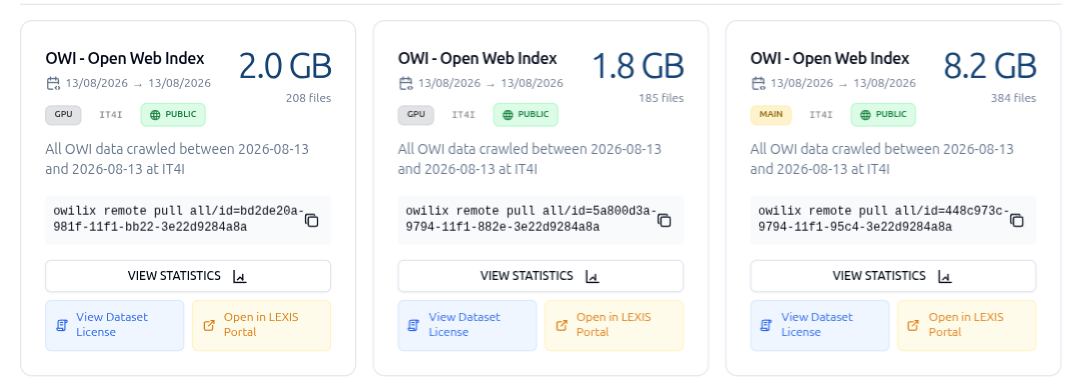
Chaque fiche de lot affiche sa collection, son volume et la commande de téléchargement.
Les collections séparent des ensembles de nature différente. La collection principale rassemble le crawl général. D’autres regroupent des pages juridiques, l’annuaire Curlie, des articles de Wikipédia ou des corpus nationaux. Chaque fiche indique aussi sa licence et la commande exacte qui récupère le lot.
Le téléchargement demande un compte. Un visiteur consulte librement les statistiques et le catalogue, puis doit s’identifier pour obtenir les fichiers. Ouvert signifie ici que les données sont publiées et réutilisables, et non que leur accès se passe de toute inscription.
Interroger l’index depuis un poste de travail
Le projet fournit un client en ligne de commande, OWILIX, dont la documentation décrit l’installation, la recherche distante et le téléchargement. Son installation crée un environnement Python isolé et ajoute la commande au chemin du système :
curl -fsSL https://openwebindex.net/owilix/install.sh | sh
Une recherche à distance interroge l’index partagé sans rien télécharger. J’ai lancé celle-ci sur le français, en demandant les cinq premières réponses :
owilix remote search "logiciel libre" --language fra --limit 5
La commande cherche les termes dans le contenu principal des pages et rend une liste d’adresses, avec un score et la date de collecte.
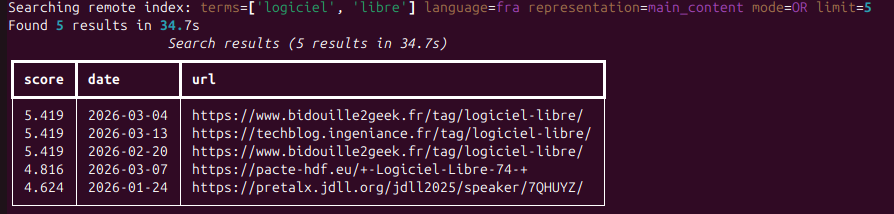
La recherche distante sert à sonder l’index avant de choisir des lots à télécharger.
Cette première requête a pris 34,7 secondes, et mes autres essais entre 29 et 56 secondes. Ces durées situent l’usage de l’outil : il explore un index partagé, à la manière d’une requête analytique, et non à la vitesse attendue d’un moteur grand public.
Le téléchargement suit la même logique. Pour me constituer un corpus de travail,
j’ai récupéré 85 lots français, soit 721 fichiers et 69,2 gigaoctets compressés,
qui contiennent 5 450 238 pages. Un
comptage par extension de domaine y trouve 411 suffixes différents, avec 1 970
732 pages en .fr et 1 754 029 en .com, suivies par la Suisse, la Belgique et
le Canada. Le filtre de langue attrape donc bien plus que le domaine national.
Voir un moteur bâti sur l’index
Le portail donne accès à OURRS, pour Open Universal Research and Retrieval System, un moteur de recherche expérimental opéré par la chaire de science des données de l’université de Passau. Il se sert de l’Open Web Index et se consulte sans compte, ce qui donne une idée concrète de ce que le socle permet.
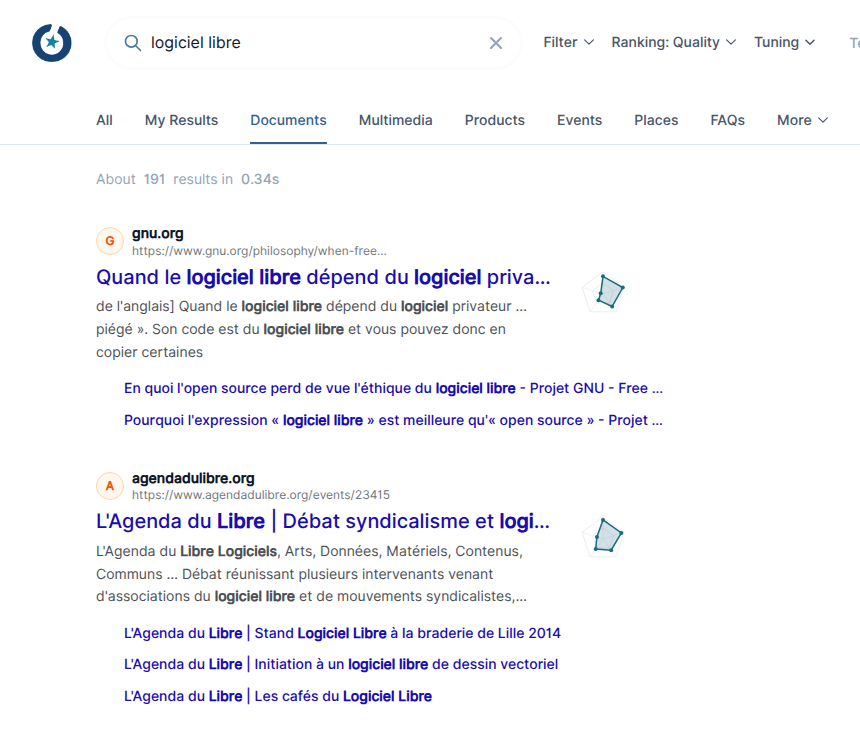
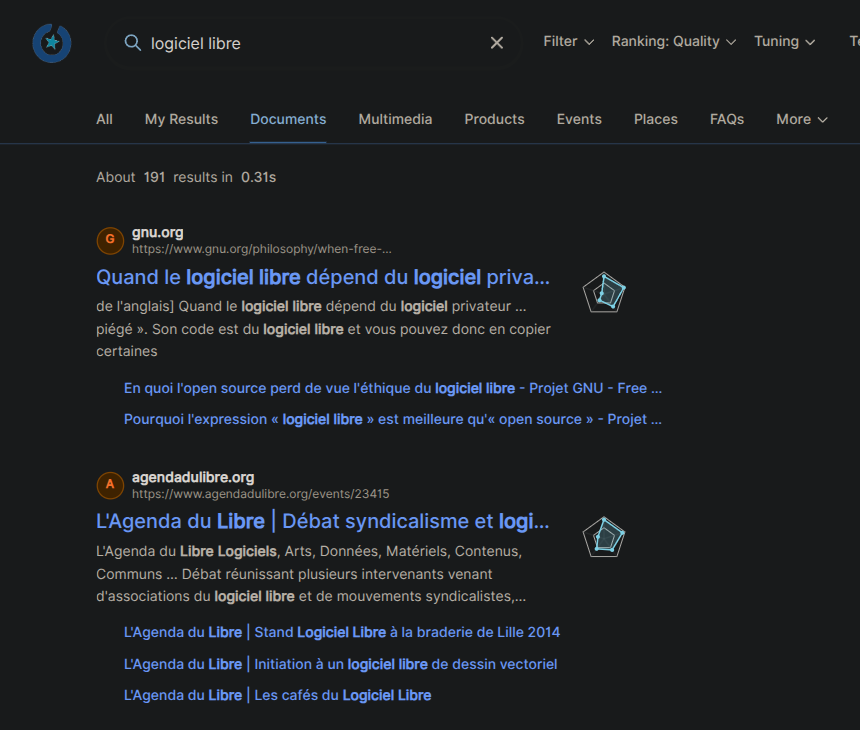
La requête « logiciel libre » dans OURRS, un moteur construit sur l’Open Web Index.
La requête « logiciel libre » renvoie environ 191 documents en une fraction de seconde, avec des pages de gnu.org, de l’Agenda du Libre et du comité pour la science ouverte. Le moteur annonce couvrir 891,3 millions de pages, 650,5 millions d’entités et 29,5 millions de sites, soit une part de l’index et non sa totalité.
Ce service reste un prototype de recherche, et il l’affiche. Ses exploitants préviennent que les données peuvent être réinitialisées pendant la reconstruction de l’index. Certains extraits montrent encore des caractères accentués mal décodés, un défaut de traitement visible à l’œil nu.
Savoir ce que la licence autorise
L’accès aux fichiers est encadré par l’Open Web Index Licence 1.0, acceptée à la première connexion. Elle réserve l’index aux usages personnels, non commerciaux et de recherche, ce qui exclut pour l’instant un service commercial bâti dessus.
Elle impose aussi une mention précise. Toute application ou publication qui utilise une partition de l’index doit afficher que le travail s’appuie sur des fichiers produits par le projet OpenWebSearch.eu, financé par Horizon Europe sous la convention n° 101070014.
Le reste du texte rappelle le statut expérimental du service. Il est fourni en l’état, sans garantie de disponibilité ni d’exactitude, le concédant peut révoquer l’accès et demander la destruction des données, et le droit allemand s’applique en cas de litige.
Limites
L’index reste un pilote. Le portail le présente en phase bêta, ses services peuvent évoluer ou devenir indisponibles, et sa couverture de 35,09 téraoctets demeure partielle à l’échelle du Web.
Les lots quotidiens se recouvrent. Une même adresse revient à plusieurs dates, avec des contenus parfois identiques. Un corpus sérieux doit donc décider s’il conserve l’historique complet ou seulement la version la plus récente de chaque page.
Les champs d’enrichissement sont inégalement remplis. Sur les 5 450 238 pages de mon corpus français, le score de qualité est vide partout, et les étiquettes thématiques issues de Curlie couvrent 1 229 959 pages, soit 22,6 %. Ces champs peuvent compléter un classement, à condition de ne pas en être la seule base.
L’avenir institutionnel du projet reste à trancher. Le financement européen s’est arrêté en février 2026, la forme juridique définitive de l’infrastructure est encore à l’étude, et la licence actuelle ferme la porte aux usages commerciaux qui assureraient d’autres revenus.
Conclusion
L’Open Web Search est le projet, l’Open Web Index est son résultat. Le premier a mutualisé la partie la plus coûteuse d’un moteur de recherche, le second la publie sous forme de lots quotidiens de pages, de métadonnées et d’index.
Ma façon de chercher au quotidien reste la même, et la différence se situe ailleurs. La brique la plus coûteuse d’un moteur existe désormais en Europe, et elle se télécharge. OURRS montre qu’un moteur peut se construire dessus, OWILIX permet de récupérer et d’analyser les lots depuis un poste de travail, et le classement, le périmètre et l’interface restent le travail de chaque application. C’est précisément la partie que le projet a choisi de laisser libre, et celle où je compte passer du temps.